Навчити штучный інтелект говорити по-русинськы
Ци реално такоє? Олем побзераєме на єден конкретный приклад.
Колись давно, у рокови 2023, публіковали сьме туйкы матеріал, в котрому сьме доста критично оціньовали шансу ґенеративных языковых моделюв квалітно приказовати по-русинськы. Была тому доста лоґічна, як ся виділо тогды, арґументація. Но проґноз ся указав не зовсім правдивый. Сучасні языкові моделы доста непудло валовшні „розуміти“ и товмачити русинськый текст на другі языкы. Поєдні люди даже хвалили ся, ож побировали навчити даякый ChatGPT нівроку файно говорити, хоть и не без серйозных хыб. Видко, ож за минулі три рокы методы научованя моделюв, як и їх кваліта, читаво выросли.
 Мигаль Лыжечко
Песимістичный проґноз из далекого 2023. року
Значит, видиме на конкретных прикладах, ож даякый ChatGPT вже доста файно розуміє текст по-русинськы и може го квалітно потовмачити до другого языка. А чом тото не фунґує у другого бока? Чом товмачіня из анґліцького на русинськый є в разы май тяжков задачов, гикой наспак?
Так ся стало, ож автор сеї публикації мав возможность на практиці попытати, як тото фунґує, у рамках свого дипломного проєкта на кафедрі системного аналізу математичного факултету УжНУ. Кой прийшов час си выбирати тему, та в дискусіях зо свойим ментором предложив єм му розобрати тему хоснованя моделув штучного інтелекту в контекстови роботы з меншиновыми и малоресурсными языками — межи котрыми маєме и русинськый. Лично мені тота тема дуже інтересна, што можете видіти и по публікаціям на Інтерфийсі в тому числі. Най вже не споминам, ож ненароком дрылив ня до сього и Петро Оринич, котрый якраз робив модел штучного інтелекту на товмачіня текста на лемкувськый варіант русинського языка.
 Гостьовый автор
Направду ментор ня выд сеї темы раз пробовав выдговорити, бо тото справді тяжка робота, звідав ня, ци побизую ся на такоє. Но выдказав єм му, ож даяка друга тема ми не така близка до серця, а завто над сим товмачом робити буде май інтересно. Резултатом того стала ся не лиш добра аналіза ситуації, но и реална проґрамка, котра бирує потовмачити анґліцькый текст по-русинськы. Та што, розкажу вам як тото было.
Як фунґує машинный товмач?
Зачати варта мало май издалека. В рамках того дипломного проєкта треба ми было зглядовати (дослідити) історію того, як домак повстав машинный переклад; выд першых примітивных систем, што товмачили лишек окремі слова, аж уже до сучасных нейронных моделув. Аж так побзерати, та гет ушыткі комерційні рішеня, які найдеме днесь, вже дораз десять рокув сут базовані на нейроновых моделах, включно з Google Translate, DeepL, Microsoft Translator, и многых другых.
Ушыткі тоты комерційні моделы фунґувут на базі архітектуры Transformer, котру формалізовали у рокови 2017. Ключовым фактором там было знебыти ся рекурентности и повностю ся опирати лиш на принцип „self-attention“, самоувагы.
Аж на хлопськый розум, сесь механізм означат, ож слова у речіньови ся не товмачат за шором, а паралелно ушыткі нараз, обы опреділити, котрі слова сут ключовыми про розуміня основного смысла. В товмачіньови за шором є ризик стратити даякый контекст першых слув, кой доходите до кунця речіня. Удказ выд рекурентности значит, ож модел не буде читати речіня по єдному слову, а буде брати цілоє речіня нараз.
Раз уже толкові модерні рішеня ся базувут на сюм принципови, та было ми ясно, ож буду и я пробовати робити модел ипен на Transformer.
Малоресурсні и меншинові языкы
Сперед тым, як ся брати до роботы, треба было якраз дослідити, які моделы и принципы хоснувут ся у роботі якраз из меншиновыми и малоресурсными языками. Варта уточнити, ож не каждый меншиновый язык є малоресурсным. В Украйині, наприклад, мадярськый ся рахує меншиновым языком, но аж нияк не може ся раховати малоресурсным. Русинськый, хоть правового статуса ипен в Украйині раз не має, якраз є малоресурсным.
Што тото значит? Малоресурсні языкы тото в булшости языкы з:
- невеликым числом людий, котрі нима говорят;
- лімітованым хоснованьом у письмови (многі языкы сут говорені, но ними ся не пише);
- малым числом паралелных словникох авадь языковых корпусув;
- слабыми позиціями в інтернетови: тыми языками тяжко штось глядати, є мало сайтув, де тым языком представлені матеріалы авадь інтерфейс.
Русинськый язык, в булшуй ци меншуй мірі, має ушыткі исі атрибуты. По-русинськы не часто ся пише — як у даякых публічных матеріалах, так и в письмах и оповістках єдно другому руснакы пишут ци по-украйинськы, ци по-словацькы, ци другым языком (никавучи, де живут). Русинськый має удносно мало языковых ресурсув и слабі позиції в інтернеті. За ушыткыми параметрами русинськый язык є малоресурсным, што кроме уже знамых нам културных проблем порождат проблемы и технічні, кой вже говориме за автоматичный переклад.
З інтересного, в похожуй ситуації є и ромськый (циганськый) язык, котрый Google додали у свуй товмач не так давно, писали сьме за тото на Інтерфийсі. Многі вызвы и проблемы в технічнуй реалізації помежи ромськым и русинськым будут доста похожі.
 Мигаль Лыжечко
Яку м выбрав технічну основу?
Проникувучи доступні роботы другої ученої челяди, котра ся занимала якраз малоресурсными языками, доникав єм, ож треба ми буде авадь Multilingual Model, де модел ся учит нараз на дакулькох языках, авадь Transfer Learning, де модел ся раз учит на великому корпусови великоресурсного языка, а дале ся доучує на малому корпусови цільового малоресурсного языка.
У реалізації подобного добрі ся провказали моделы mBART, MarianMT, NLLB-220. Спомежи них выбрав им якраз MarianMT, бо діла мого дипломного проєкту мусів єм учинити фреймворк, котрый бы ся дало зреалізовати з обмежеными технічными ресурсами (на слабому компютерови), а „Маріаш“ помежи сима моделами має майскромный апетит на оперативну памнять. У самуй дипломнуй роботі многым май детально прониковав єм розлуку помежи сима моделами и арґументовав свуй выбор, айбо в рамках сьої статі можеме тото выпустити.
Намітив єм си такый план роботы, ож возьму за основу „Маріаша“, научу го великым анґліцько-украйинськым корпусом, а дале го доучу вручну зобраным меншым анґліцько-русинськым корпусом. За принципом Transfer Learning, модел бы мала побировати перенести основні знаня з єдного близкого языка на другый, а ручный русинськый корпус бы лиш фіналізовав як ото має у кунци вызирати.
Великый анґліцько-украйинськый корпус найти было не тяжко, сут доступні онлайн в одкрытому доступови. А вже анґліцько-русинськый мусай было даяк збирати самому. Ба як?
Формованя ручного языкового корпусу
З тых робот, котрі м читав в контекстови якраз Transfer Learning, люди рекомендовали зобрати ручный корпус на доучованя на хоть 20 тисяч речінь. Сесе ся може видіти невеликов цифров, айбо в текстови, котрый теперька читаєте, є менше 200 речінь. А їх бы щи пак треба нормалізовати и потовмачити… Та треба было файно померьковати, выдкі бы брати тулькый текст!
Значит, глядавучи входный матеріал діла тексту, треба ми было найти дашто, што бы мало баланс сих двох критеріюв:
- жерело тексту має быти масовым, великым, обы было з чого выбрати;
- жерело тексту має мати релатинвно стабілну ортоґрафію, обы не треба было вручну много переписовати.
Порозумів єм, ож публікації журнала „Отцюзнина“ ачей бых стали майліпшов основов діла ручного корпуса, бо журнал має доста много выданых чисел и має удносно невелику ортоґрафічну варіативность помежи числами. Щи єдна выгода, за котру м на зачатку и не подумав, ото тематика. Выбор сього журнала за основу подаровав ми публикації на всякі темы: інтервю, історія, етноґрафія, и просто публіцистика. Сесе бы побизовало, ож будучна модел буде мати лексику и контекст на вшелиякі темы.
Аж вам інтересно — публикації з Інтерфийсы у зачаточный корпус раз не зайшли, бо розлука у ортоґрафії была повелика, обы ї побороти вручну в куртый час.
Нормалізація тексту: інтересні технічні проблемы
Дуже важным етапом, мож даже уповісти ключовым, была нормалізація ручного корпусу. Треба было кым май силно звести входні тексты до єднакого виду. Треба было мінімізовати число инчакых форм єдного слова, обы не розпорошовати токенізацію.
На хлопськый розум, єден „токен“ ото єдно слово. А значит модел буде брати слова „вшытко“ и „ушытко“ як два окремі токены, и проличовати їх контекст окреме. Тото самоє из синонімами. Та треба ся было читаво постарати, прогадковати, обы тоты самі слова ся писали єднако помежи числами журнала крузі рокы. И, як сьте ся могли догадати, ото не было так легко. Долув розкажу лиш за частину проблем и як єм їх рішав, выд май легкого до май тяжкого.
- Епізодичноє хоснованя буквы ⟨ӱ⟩. Перші числа журналу хосновали тоту букву на позначіня рефлексу прасловянського *о у новозакрытому складови. Тото звук, характерный бережанському діалектови русинського языка. У послідньых числах журнал ся выд тої практикы удказав, а значит діла нормалізації тексту, обы не розпорошовати увагу модела, треба было тоту букву у текстови усягды ушмарити гет и замінити на ⟨у⟩.
- Спорадичноє хоснованя буквы ⟨ô⟩. Перші числа журналу хосновали тоту букву на позначіня инчакого выговора звука „о“ у специфічных позиціях. Хоть, направду, хоснованя не было системным. Так само ї треба было ушмарити и замінити на ⟨о⟩, обы не розпорошовати токенізацію.
- Несистемноє хоснованя буквы ⟨ґ⟩. На чудо, перші числа журналу, што ся выдавали пуд нормы Анны Меґелы, не хосновали домак букву ґ. А значит, привычні вам ґаті авадь ґазда писали ся там як „гаті“ и „газда“ удповідно. У послідньых числах новый коректор журналу увюг розлучноє хоснованя ґрафем ⟨г⟩ тай ⟨ґ⟩, обы зодповідати живому факту русинського языка, за што в „Отцюзнині“ быв и окремый матеріал. Туйкы технічно задача вже была многым май інтересна, тай рішати м ї мусів не вручну. Раз єм зобрав у малый документ слова из буквов ⟨ґ⟩ из новых чисел, а дале м написав алґоритм, обы найти слова из май старых чисел журнала и зкореґовати написаня. Тото не было стопроцентно бизувноє рішеня, айбо многым ми упростило задачу.
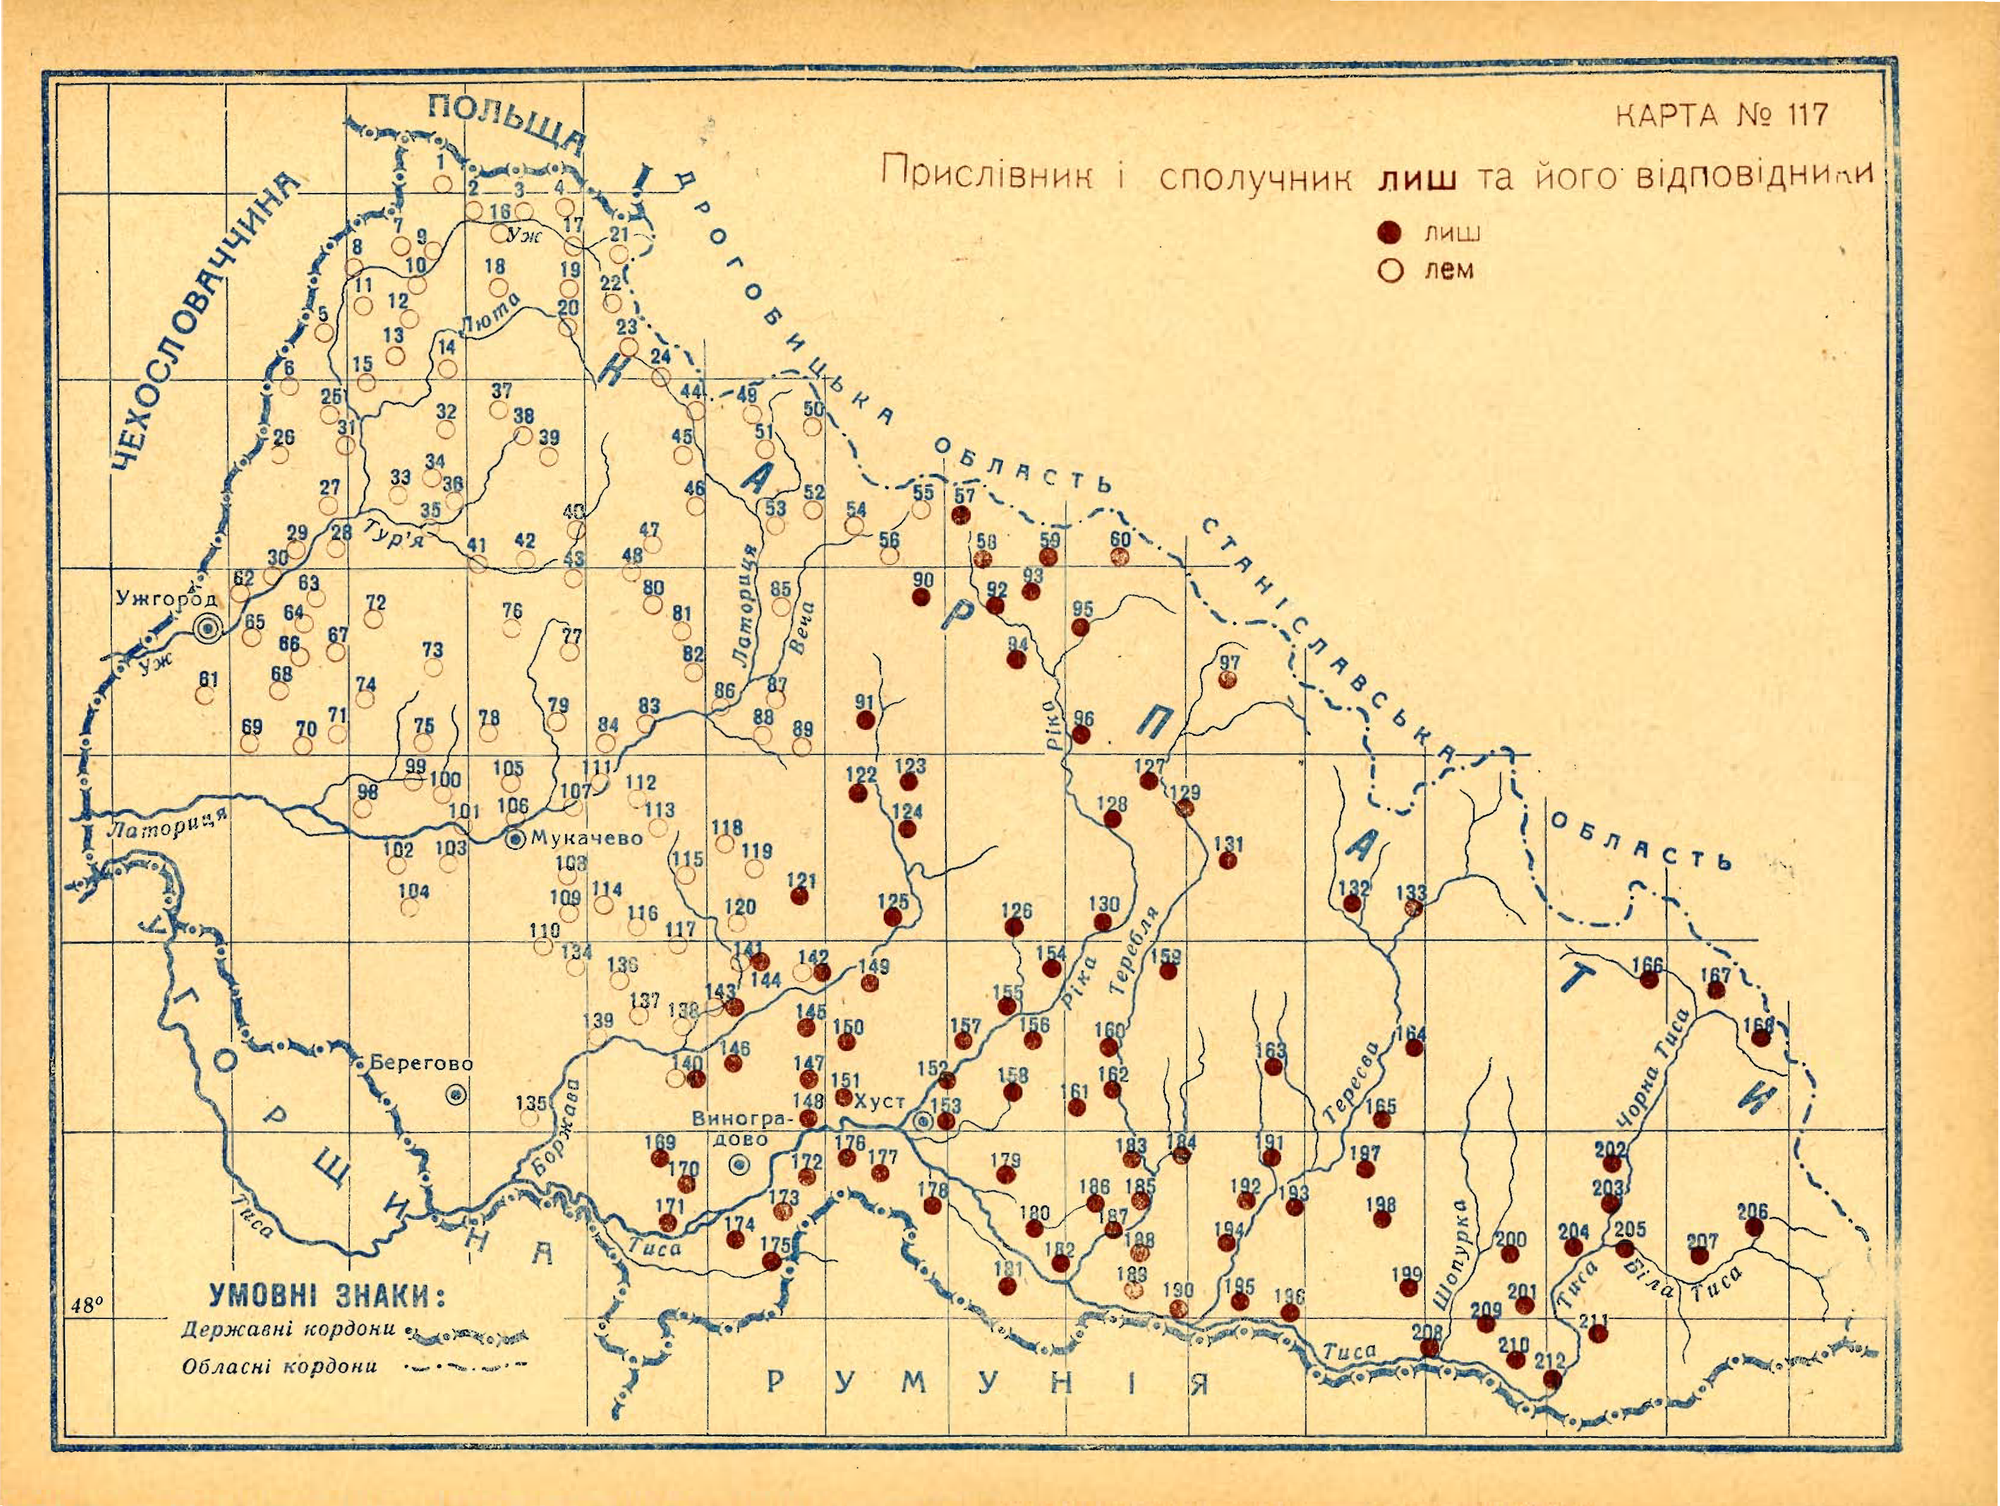
- Паралелноє хоснованя „лем“ тай „лиш“. Редакція журналу поволяла авторам даяку слободу у ортоґрафії, но щи май — у лексиці. А значит, были трафункы паралелного хоснованя у текстови и лем, и лиш. Обы применшити розпорошеня токенізації, та гія бы было выбрати єдно из сих двох слув, так як они сут руными одповідниками єдно другому, просто з другых діалектув. Лиш є територіално май пошырена у нас в Пудкарпатьови, як лем, а значит ближа читачови. Айбо в тот самый час лем є май спознаваным маркером ипен нашої бесіды, што є добрым арґументом выбрати ипен лем-каня. Мої компетенції є помало, обы зробити такый нормотворчый выбор, та послідовав єм за редакційов журнала „Отцюзнина“ и лишив єм паралелноє хоснованя ободвох слув, осознано розумівучи, ож сесе потенційно шкодит точности товмачіня будучного моделу.
- Паралелноє хоснованя „ож“ тай „же“. Руно ідентична ситуація, як у минулому трафунку. Єдно слово є май пошыреноє ги другоє, но обадва ся стрічавут у текстови. И руно так само я, як технічный спеціаліст, не можу на ся брати такі май тяжкі языкові вопросы. Лишив єм обадва варіанты.
 Редакція «Отцюзнины»
Щи єдным інтересным технічным нюансом была сеґментація речінь. Діла далшої обробкы, мав єм потребу розділити удсканованый документ так, обы каждоє окремоє речіня было у єден шорик. Майліпшым орієнтиром кунця речіня є, само собов, цятка. Айбо так ся стало, ож на удміну выд языка украйинського, де цятков ся кунчавут речіня тай пишут ся куртанкы, та в русинському языкови цятков ся щи й означувут порядкові числа — „першый“ буде ся писати як „1.“. Треба было доста довго пробирати текст вручну, обы правилно поскапчовати уєдно речіня, котрі ненароком были розбиті на окремі шорикы. Бо даґде тому винов быв порядковый номер, а подаґде у сканови были просто нумеры сторункы… Словом, ото была страшна бабрачка.
Не в послідньому шорі треба спомнити и за жанрову філтрацію. Из удсканованого документа треба было вручну поушмарьовати ушытку поезію, котра ся доста часто стрічала у першых числах журналу. Діла нашого трафунку, коли треба зробити проґраму-товмач, та поезія має меншу цінность у корпусі. Мало того, ож в поезії фурт ся допущат щи май слобудна ортоґрафія як у шоровых текстах, поезію щи й многым май тяжко товмачити.
В резултатови сякої критичної чисткы из зачаточных удсканованых 10 тисяч шорикув, дустав им лишек 1774 речіня, на котрі м ся муг побизовати. Ото обєктивно дуже мало, аж другі учені рекомендовали маймало 15–20 тисяч. Айбо спозад обмежінь в часови и ресурсах, сесе было майліпшоє, што м муг досягти.
Што з того выйшло? Ци добрі товмачит?
Резултатом роботы став дуже маленькый модел, што важит мало булше як ґіґабайт, и валовшен товмачити прості речіня з анґліцького языка на русинськый. Правда, накулько добрі товмачит, залежит выд контексту и темы бесіды. Пониже можеме розпозерати приклады, котрі м мав у презентації роботы проґрамы.
|
Входноє речіня по-анґліцькы |
Зґенерованоє товмачіня |
Субєктівна оцінка |
|---|---|---|
|
Can I offer you a coffee? |
Могу я запропонувати вам каву? |
Товмачіня фактично доброє, но стилістика и лексика перейнята з украйинського. |
|
How do I train my AI model? |
Як учити свою компетенцію ютя? |
Недобрі потовмачено. Технічна термінолоґія была слабо представлена у русинському корпусови. |
|
This historical figure was very important for Ungvar |
Сеся історична постать была дуже важна для Унґвара. |
Добрі потовмачено, повностю усокочена стилістика. |
|
Please provide me with accesses |
Надайте, будь ласка, про доступы. |
Часточно добрі потовмачено. Чудна семантика. |
|
I'd like to order a cheeseburger |
Я бы заказовав чізбургер. |
Часточно добрі потовмачено, но утраченый час. |
Оціньовати кваліту товмачіня субєктивно є легко, айбо в тот самый час тяжко, бо каждый окремый челядник може уповісти „сесе не по-нашому“ тай готово. З мало май обєктивных критеріюв маєме готові інструменты, котрыми мож поміряти кваліту товмачіня алґоритмічно. Ото сут метрикы BLEU тай chrF.
- Метрика BLEU (Bilingual Evaluation Understudy) оцінює подобность входных текстув в корпусови ид готовому товмачіньови. Муй модел набрав ~14 балув у сюй метриці.
- Метрика (Character n-gram F-score) є подобна, но оцінює не цілі слова, а посимболну (побуквову) подобность входного текста на товмаченый. Муй модел набрав ~45 балув у сюй метриці.
Аж руняти з реалными комерційными товмачами, та сесе дуже слабый резултат, котрый мало де бы найшов практичноє хоснованя. Но майслабым містом, як ми ся видит, быв входный корпус даных. Так си гадаву, ож при русинському корпусови на менш як дві тисячі речінь, сесе щи непудлый резултат! А кым май аж пробовати товмачити тексты історичного филя, та модел указує доста файні резултаты. Сесе бы мало быти напряму скапчано з тым, ож послідні числа журналу мали повно публікацій на історичну тематику. В тот самый час видиме, ож з технічными темами модел не валовшен си порадити, тай нагадаєме ся, ож тексты з Інтерфийсы в корпус раз были не зайшли.
Так само видко, ож много де модел „тягнув“ у товмачіня авадь украйинську авадь анґліцьку семантику там, де не мав прикладув русинського тексту. Сесе быв чеканый резултат, и другі дослідникы за сякоє казали.
Што з тым дале?
Ци буде из сякої серсамы даякый практичный хосен? Набизувно айно: мож си придумати повно сценаріюв, куды мож сякый модел прикапчати. И туй кажу не лишек за даякый аналоґ Google Translate, котрый сам выд себе вже бы мав добрый потенціал.
Єдна з ідей, яка ми засіла в голову, ото розшыріня до бравзера, котроє бы могло потовмачити веб-сторунку. Аж знаєте, булшина бравзерув, гикой Google Chrome, можут вам предложити потовмачити веб-сторунку из незнамого языка на тот, котрый маєте включеный в інтерфейсови компютера. Дашто подобноє не тяжко бы зробити через розшыріня до бравзера, котроє бы по API комуніковало из моделом и адаптовало вам текст. Сякым падом из дуже невеликым трудом, каждому руснакови бы ся удкрыв цілый анґлоязычный інтернет!
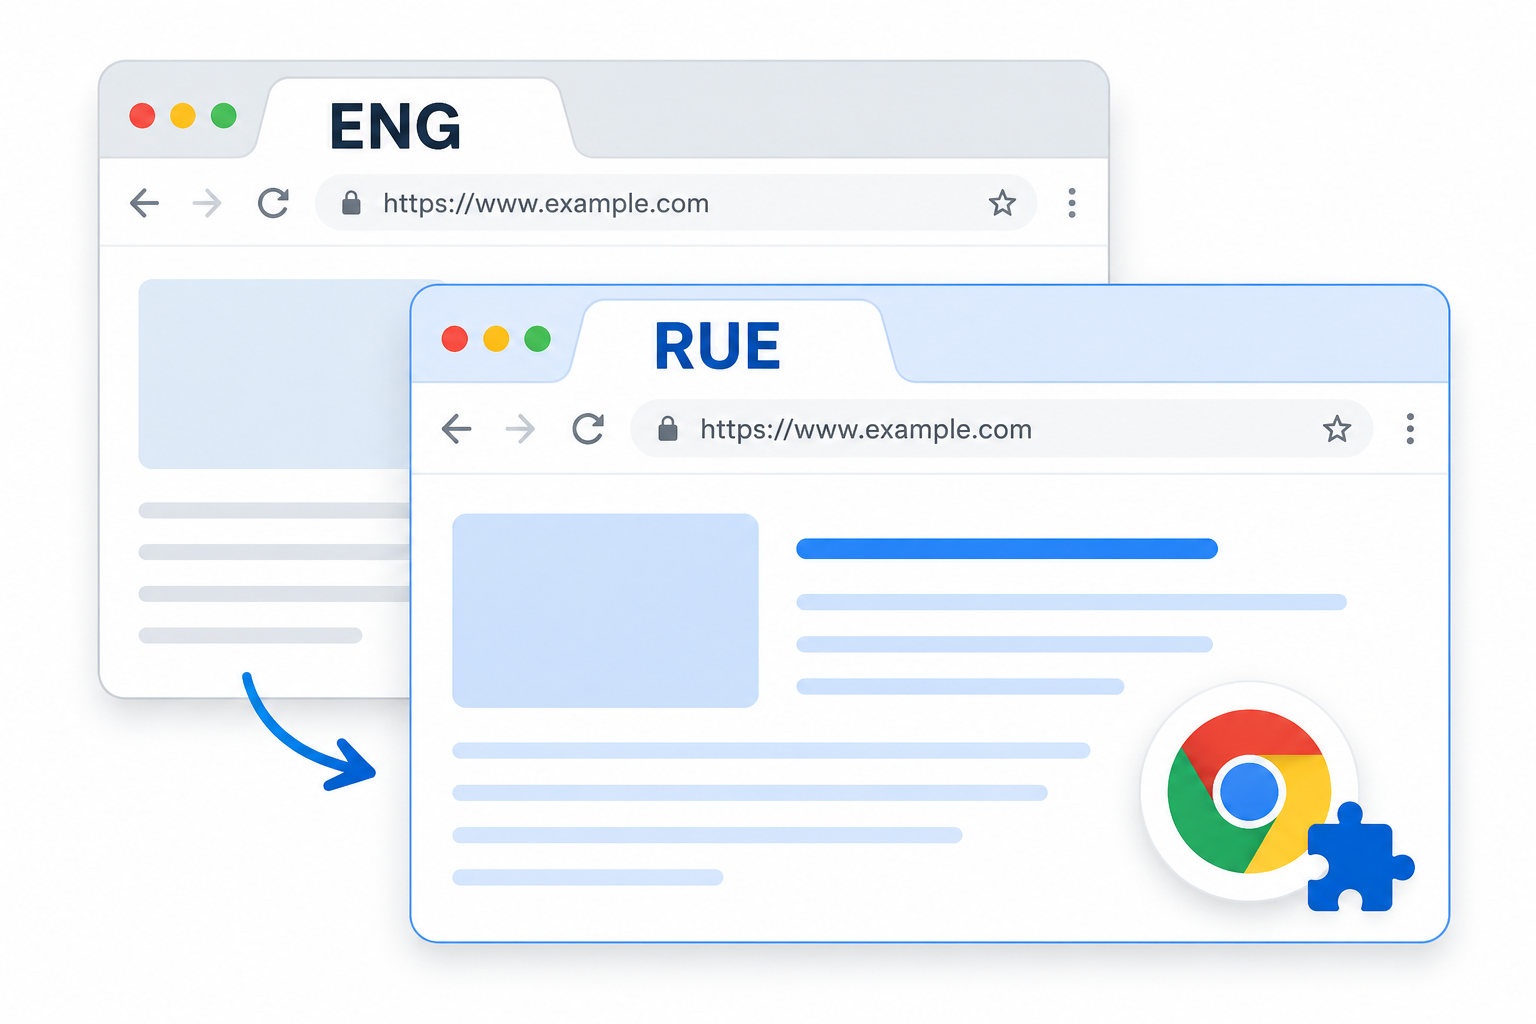
Правда, обы тота потовмачена сторунка вызирала добрі, и было ї приємно и понятно читати по-русинськы, та раз треба читаво зліпшити кваліту самого товмачіня. А значит, треба зобрати многым май великый языковый корпус, котрый бы быв вже нормованый.
Гикой челядник, котрый сесе мусів робити почти повностю вручну, мушу признати, ож єден літературный стандарт про руснаку (бодай в рамках Украйины) читаво бы злегшив исю задачу. Но не сам факт вызнатя того стандарту — ото вже окрема дизкусія — а обы тым стандартом было написано много тексту. Майвеликым каміньом, проблемов, про мене была ручна нормалізація тексту, ручноє переписованя слув, котрі ся єден автор дорадив писати сяк, а другый инчак. Не позиравучи на тото, ож я доста позитивно никаву на языковый плуралізм у нашум краю, сугубо з технічної стороны тото є кара небесна, котра читаво гамує збираня матеріалу на такый модел, а значит применшує кваліту товмачіня и збулшує часозатраты на сотворіня проґрамованых рішінь.
Почитати ориґінал мої бакалаврської роботы по-украйинськы можете туй:


Коментарі () • Правила коментованя